资料截止:2026 年 10 月 2 日。本文依据厂商公开资料、论文、拆解与第三方测试整理,不是本站亲测。厂商给出的提升幅度保留其比较对象与条件;不同版本跑分不混排。
提到麒麟,讨论很容易跳过芯片本身,直接变成“遥遥领先”或者“落后几代”。可真正值得追问的,是几个具体问题:同样一个任务,能多快完成?完成它要多少电?手机热起来之后还能保持多久?这些进步来自制程、架构,还是软件?
截至本文写作时,麒麟已经走到 9050 Pro。“韬定律”也不再只有发布会上的一句口号:有正式发表的论文,有后续热设计讨论,也有搭载新芯片的零售手机。但从“提出一种有效方法”走到“全面超过所有竞争对手”,中间还隔着大量需要实测的项目。
本文采用一个简单原则:能从原始资料确定的就说清楚;只能支持局部结论的,不扩展成全面胜利;尚未公开的,不拿猜测填满参数表。
一、先把“麒麟芯片”拆开
手机里通常说的“处理器”,实际上是一颗 SoC,也就是片上系统。CPU 负责通用计算;GPU 负责图形和部分并行计算;NPU 面向神经网络;ISP 处理相机数据;缓存、内存控制器和互连负责把数据送到正确的位置。通信能力还涉及基带、射频与天线系统,不能用一个 CPU 分数概括。
理解架构时,要分清四件事:
| 层次 | 它回答的问题 | 常见误读 |
|---|---|---|
| 指令集 | 软件向处理器发出什么指令 | 使用 Arm 指令集,就一定使用同一款 CPU 核心 |
| 微架构 | 核心如何取指、执行、预测分支、访问缓存 | 同频率一定同性能,核心越多一定越快 |
| SoC 集成 | CPU、GPU、NPU、内存如何协作 | CPU 跑分就是整颗芯片的全部水平 |
| 制造与封装 | 电路如何被制造、连接和散热 | 名义纳米数相同,密度、功耗和成本就相同 |
自研微架构与使用 Arm 指令集并不矛盾;采购标准 CPU 核心,也不代表整颗 SoC 没有设计工作。同样,“国产芯片”是一个产业链语境下的概念,不能由这四个字推导出所有指令、IP、设备和设计工具都来自同一体系。
还要注意核心与线程。操作系统显示的逻辑处理器数量,不必然等于物理核心数量。支持同时多线程的核心,可以让多个线程共享执行资源;它有助于提高利用率,却不是凭空复制出另一颗完整核心。跨品牌比较“几核”,如果连物理核、线程都没分清,起点就错了。
二、从 970 到 9000:麒麟曾经靠什么进步
回看历史,比直接争论最新产品更容易看清技术路线。下面三代都有海思官方规格可查。
| 芯片 | 官方制程与晶体管数 | CPU / GPU | 当时值得关注的方向 |
|---|---|---|---|
| 麒麟 970 | 10nm、55 亿 | 4×Cortex-A73+4×A53;Mali-G72 12 核 | 在手机 SoC 中引入专用 NPU |
| 麒麟 980 | 7nm、69 亿 | 2×A76 大核+2×A76 中核+4×A55;Mali-G76 10 核 | 三档 CPU 调度、双 NPU |
| 麒麟 9000 | 5nm、153 亿 | 1×A77 3.13GHz+3×A77 2.54GHz+4×A55 2.05GHz;Mali-G78 24 核 | 5G 集成、达芬奇 NPU、ISP 与系统缓存协同 |
这段历史说明,麒麟的竞争力一直是多项工程共同作用的结果。制程提供晶体管预算,CPU 和 GPU 消耗预算,NPU 与 ISP 把特定工作搬到更合适的硬件上,软件再决定这些硬件能否被充分利用。
但老麒麟 9000 的 5nm 规格,不能直接套到名字相似的 9000S 上。型号延续不是制造工艺延续。讨论回归后的麒麟,必须重新查看对应型号的拆解与测试。
到了 9030 Pro,制造与电路设计仍然是理解性能的重要背景。SemiAnalysis 对 SMIC N+3 的公开拆解将其放在第三代 7nm 路线上,并讨论了多重图形化与设计工艺协同优化。这能说明持续迭代,却不支持把某个局部金属间距直接翻译成“整体已经等于另一家的先进节点”。拆解原文
三、9050 Pro 的重点:不只把频率再拉高一点
华为在 Mate XT 2 非凡大师官方页面明确列出麒麟 9050 Pro,并在 2026 年 9 月的技术说明中确认 LogicFolding 的商业应用。它把我们带到一个新的问题:当继续缩小平面晶体管的条件受限时,能不能从电路连接方式入手?产品资料、华为 LogicFolding 说明
图 1:华为 Mate XT 2 官方产品页的芯片示意图。它是宣传渲染图,不是裸片显微照片。图源:华为。
极客湾对零售 Mate XT 2 的测试显示,9050 Pro 的变化同时涉及核心配置、频率和多核表现。因此,把这一代的进步简单理解成“旧芯片超频”,并不符合测试呈现的整体变化。但型号更新,也不意味着每种负载都同比例提升。极客湾原始测评
这里尤其需要留意官方页面中的“整机性能”。如果对比对象同时换了手机、系统版本和应用版本,测到的就是整个产品的综合结果。它可能包含调度、编译、内存管理和应用优化,不能把整机提升百分比全部记到 CPU 微架构头上。
对普通用户,这些软件收益当然有价值。只是技术归因必须准确:体验变快,与每个计算单元都同比例变强,是两个不同命题。
四、跑分怎么看:先统一尺子,再讨论输赢
2026 年一个很容易踩的坑,是把 Geekbench 6 与 Geekbench 7 放进同一张排行榜。Geekbench 7 更新了工作负载,加入或调整了媒体、语音识别、物理模拟等测试,并改变部分多线程测试设计。因此,GB6 的 3000 分和 GB7 的 3000 分,不能视为同一个性能刻度。Geekbench 7 官方说明
第二个坑,是只看最高分。假设一颗芯片在 6W 达到某个分数,另一颗需要 10W 才达到相同分数,两者峰值分数一样,装进轻薄手机后的体验却可能很不一样。继续加压加频带来的最后一点性能,有时会用掉明显更多的功耗。
因此,比孤零零的跑分更有信息量的是性能—功耗曲线。横轴是功耗,纵轴是性能:相同功耗看谁更高,相同性能看谁更靠左。曲线末端向右延伸很多、向上增加很少,通常意味着继续冲峰值的代价变大。
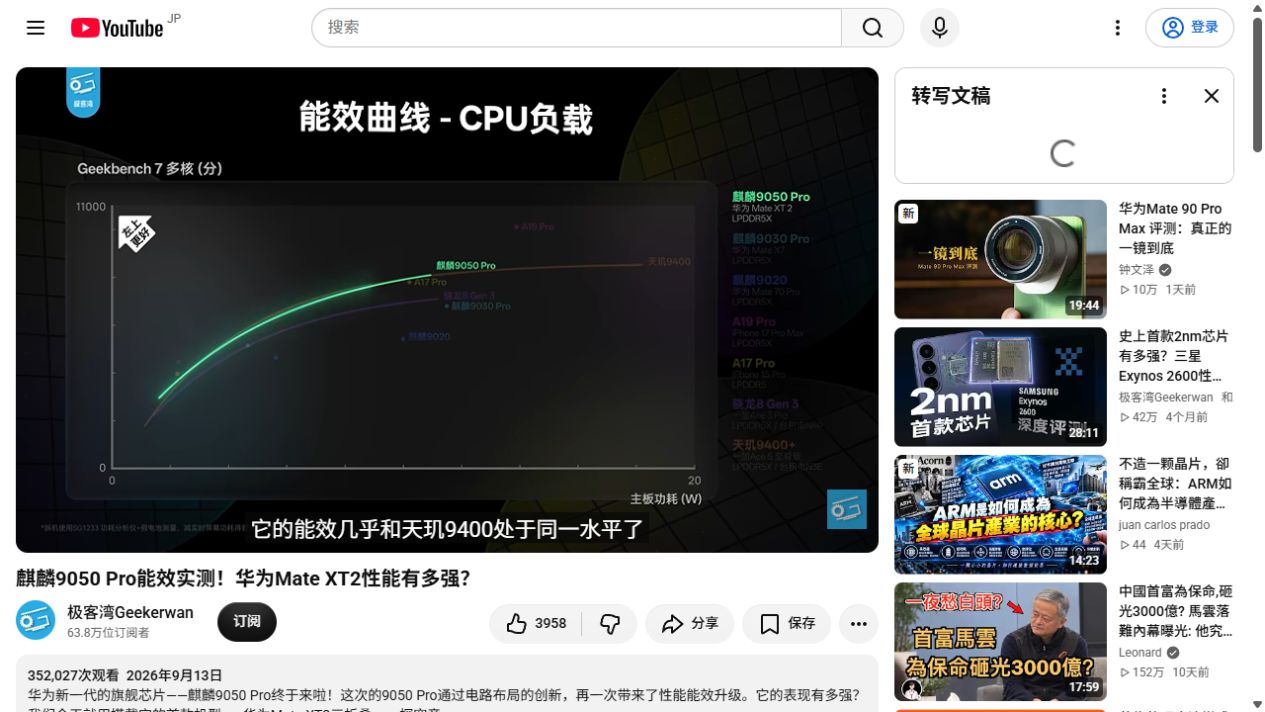
图 2:极客湾《麒麟9050 Pro能效实测!华为Mate XT2性能有多强?》约 8 分 11 秒画面,保留测试图与视频页面出处。纵轴为 Geekbench 7 多核,横轴为主板功耗。原视频发布于 2026 年 9 月 13 日,页面标注知识共享署名许可。作者:极客湾 Geekerwan。本图不代表本站测试。
从这张原始图可以读出三个有边界的结论。
首先,9050 Pro 相对 9030 Pro 的多核曲线有明确改善。它不是只靠把曲线末端推向更高功耗来换一个好看的峰值,常用功耗区间的表现同样值得关注。
其次,在这组 Geekbench 7 多核测试中,9050 Pro 的曲线接近图中的天玑 9400+。视频解说也用“能效几乎和天玑 9400 处于同一水平”描述这部分结果。这是一个具体负载下的重要进步,但它不等于所有 CPU 工作、GPU 游戏和整机续航都达到相同水平。
第三,图中 A19 Pro 的高分点仍然高于 9050 Pro 的已展示区间。既不能因为麒麟有明显进步,就抹掉这个差距;也不能只拿苹果的最高点,忽略两者曲线与运行条件。
为方便阅读,可以对这幅图做一次保守的读图整理。以下是粗略刻度区间,不是原始成绩单,不用于计算百分比:
| 同一幅 GB7 多核图中的样本 | 图示高端区间的大致位置 | 能支持的判断 |
|---|---|---|
| 麒麟 9020 | 约 5000—6000 分区域 | 是较早一代的参照 |
| 麒麟 9030 Pro | 约 6500—7500 分区域 | 相对 9020 已有提升 |
| 麒麟 9050 Pro | 约 8000—9000 分区域 | 多核曲线进一步上移 |
| 天玑 9400+ | 高端延伸至约 8500—9000 分区域 | 与 9050 Pro 部分功耗区间接近 |
| 苹果 A19 Pro | 约 10000 分以上区域 | 展示点的多核上限仍更高 |
这些区间刻意没有写成个位数精度:截图读取做不到那种精度,也不能代替原始数据。骁龙 8 Gen 3 也出现在原图中,可用作历史参照;它不是 2026 年最新骁龙,更不能用这张图给新一代旗舰排总榜。
极客湾的 SOCPK 数据库还说明,其能效测试采用拆机、假电池、多频点测量等方法,并扣除屏幕功耗取得主板功耗。主板功耗不等于单独 CPU 核心功耗,也不等于你拿在手里的整机耗电。数据库会更新,复核时还应确认所选测试版本。SOCPK 能效数据库
单核、多核、游戏,分别回答什么
单核成绩更适合观察单线程任务的完成能力,但它仍包含缓存、内存访问与编译器影响。多核成绩反映可并行负载,不代表打开每个应用都能按同样比例加速。一个主要线程卡住的任务,不会因为后台还有十几个逻辑线程就自动快一倍。
游戏则要另外测试。相同游戏名称,不一定意味着相同画质:分辨率、动态分辨率、阴影、渲染 API、插帧和超分辨率,都可能改变工作量。平均帧率也容易掩盖卡顿,最好同时看帧时间曲线、低帧表现、温度和长时间运行后的功耗。
所以本文不拼接来源不一的截图,制作一个看似精确的“四家总分榜”。有完整条件的局部比较,比缺少条件的完整排行榜更有价值。
五、“韬定律”到底说了什么
“韬定律”对应的技术表述是 τ scaling,可以理解为围绕特征时间进行缩放与优化。2026 年 5 月,何庭波在 IEEE ISCAS 相关主题演讲中介绍这一路线;7 月 21 日,论文《A time scaling theory for multi-layer electronic systems》正式发表于《Science China Information Sciences》,文章类型为 Position Paper。华为演讲报道、正式论文
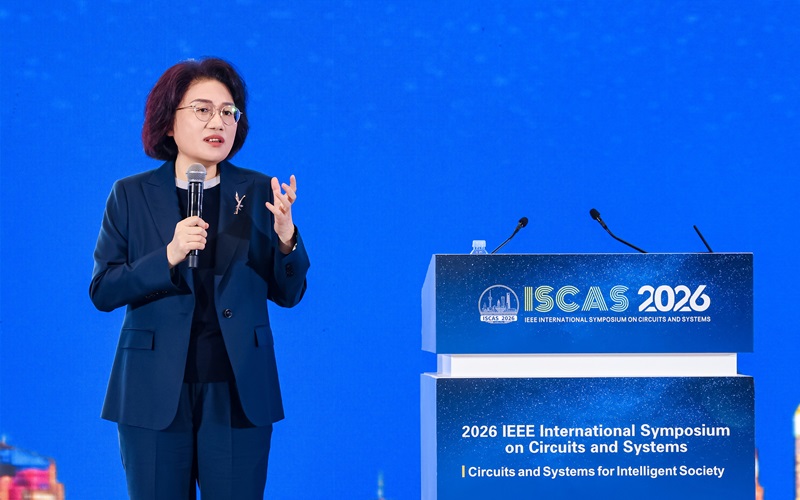
图 3:何庭波在 ISCAS 2026 的公开演讲照片。这是技术会议现场图,并非手机新品发布会截图。图源:华为官方新闻。
它的出发点不难理解。过去谈芯片进步,常把目光集中在“晶体管做得更小”。但计算任务不只是晶体管在开关,还包含电路连线、片上数据搬运、存储访问,以及多芯片系统之间的通信。某一部分算得再快,如果大量时间消耗在等待数据上,整体收益也可能有限。
τ scaling 尝试用“时间”把这些层次放到同一个优化视角里:器件层关注开关时间,电路层关注互连延迟,芯片层关注计算与数据移动,系统层关注通信和任务完成。这里的“统一”是统一分析目标,不是说所有层次都能不加区别地塞进同一个常数,按一下按钮就整体翻倍。
LogicFolding:缩短连接,不等于简单叠两颗芯片
论文中的手机 SoC 实例叫 LogicFolding。它把数字、模拟与存储相关电路安排到垂直堆叠的有源层,并通过细密的垂直互连重新组织电路。可以把问题想象成一座城市:道路上的车辆速度有限,但如果原本相隔很远的部门能合理安排到相邻楼层,一部分交通距离就会缩短。
这个比喻也有边界。电路不能随意搬家,时钟、供电、散热、工艺波动和制造良率都会限制布局。普通封装堆叠、把内存放在处理器上方,以及在更细粒度上重组逻辑连接,并不是完全相同的技术层次。不能看到“3D”或“堆叠”两个字就一概而论。
论文公开了一个有助于理解收益与代价的 CPU 对照。下面保留原表条件与归一化口径,而不是改写成“全手机省电 41%”。
| 指标 | 麒麟 9030 Pro 对照 | 论文中的 Kirin 2026 |
|---|---|---|
| 温度条件 | 25°C | 25°C |
| 电压 | 1.1V | 0.9V |
| 频率 | 2.75GHz | 2.5GHz |
| 等性能归一化功耗 | 1 | 0.59 |
| 归一化面积 | 1 | 0.625 |
| 归一化功率密度 | 1 | 0.944 |
据论文表 1 整理。它描述特定设计和测试条件,不能当成零售手机所有场景的固定比例。原文由 Tingbo He 撰写,采用 CC BY 4.0 许可;本节对原文作了中文概括与表格重排。论文入口
这张表最有意思的地方,是新方案频率更低,却能在所选任务中达到对照性能。这提醒我们,GHz 不是完整的性能单位。每周期完成的有效工作、等待时间与数据路径,都可能改变结果。
功耗从 1 变成 0.59,意味着相同任务性能下功耗下降 41%。若只在这个相同条件下换算每瓦性能,提升是 1 ÷ 0.59 − 1 ≈ 69.5%。这是同一组数字的数学换算,既不是另一次实测,也不能再把两个百分比相加。
面积变成 0.625,功耗变成 0.59,功率密度便约为 0.59 ÷ 0.625 = 0.944。因此,功耗大幅下降,并不意味着单位面积发热强度也会按同样比例下降。设计越紧凑,越需要认真处理热点。
41%、55%、58%:每个数字都要带着条件读
论文及官方资料提到的晶体管密度提高约 55%,涉及该设计的密度定义与集成方式。它不能与另一篇拆解里按照不同标准单元、不同面积边界估算的 MTr/mm² 直接相除,更不能直接宣布“名义制程从某纳米变成了某纳米”。平面面积、跨层集成面积、标准单元密度和整颗裸片平均密度,是不同口径。
9 月的后续预印本进一步讨论热设计,并明确展示不同工作负载:CPU 采用 HNX 相关测试,GPU 的等性能比较取自特定游戏帧。文中甚至给出一个功耗下降而功率密度上升的 DSP 例子。这些条件恰恰说明,不能把某个模块的降耗百分比广播到整个 SoC。后续预印本
从基础电路关系看,动态功耗常用 P ≈ α × C × V² × f 描述。降低电压、减少需要驱动的电容、减少无效活动,都可能降低功耗;但真实芯片还有漏电、供电损耗与复杂的温度反馈。更短的时间路径为优化创造空间,不保证任何设计、任何工作负载都自动省电。
它是不是“取代摩尔定律”
更准确的理解是:它提出一种跨层协同优化的路线,并用工程实例支持其有效性。正式发表说明这已经进入公开学术讨论,但“定律”这个名字不意味着它具有无条件成立的自然定律地位。
它不让先进制程失去价值,也不消除光刻、材料和制造能力的限制。先进制造、电路优化、封装与软件可以同时贡献收益,竞争对手也不会停止进步。对普通读者,最有意义的验证仍然是:相同任务、相同体验目标下,零售产品是否更快、更省电,成本与可靠性是否可接受。
论文中的长期路线图还必须与当前实物分开。未来集成密度、系统规模或者等效节点的目标,是预测与规划,不是今天已经量产的制造节点。现有公开资料也不足以让外部读者精确计算完整量产成本与良率,本文不为这些空白编造数字。
六、与骁龙、天玑、苹果 A 系列放在一起看
比较首先要选对时代。用 2026 年的麒麟,对照已经上市多年的竞争芯片,能说明追赶到了哪一个历史参照点;但要判断当年的旗舰竞争,还应看同年度的新平台。
截至资料截止日,三家竞争平台已经公布新的产品。下面这张表列的是官方架构与功能方向,不是四家同台实测排名。
| 平台 | 已公开的架构重点 | 对比时最该追问什么 |
|---|---|---|
| 麒麟 9050 Pro | LogicFolding 商业应用,结合鸿蒙原生软件与整机设计 | 曲线改善能否覆盖不同 CPU、GPU 和真实应用负载 |
| Snapdragon 8 Elite Extreme Gen 6 | 自研 Oryon CPU,两个 Prime 核最高 5GHz;Adreno 引入矩阵计算核心 | 高频峰值的功耗代价,以及长时间游戏表现 |
| 天玑 9600 Pro | 官方标注台积电 2nm;2+3+3 CPU 配置,最高 4.55GHz;G2 Ultra NX GPU | 多核与缓存收益,实际机型的性能释放和调度 |
| 苹果 A20 Pro | 官方标注 2nm;6 核 CPU、7 核 GPU,双 16 核 Neural Engine | 单线程、持续负载,以及软硬件协同带来的实际收益 |
来源:高通产品页、联发科发布资料、苹果发布资料、华为产品资料。
图 4:苹果新闻稿中的 A20 Pro 官方发布素材,用于说明同年度竞争平台。图源:Apple Newsroom。宣传示意图不能用于推断真实晶体管布局。
高通的观察重点,是自研 CPU 与图形系统如何转化为实机表现。官方列出的 CPU 提升 13%、GPU 提升 44%,比较对象都是其上一代。这些数字可以解释代际目标,不能直接拿来和华为“下降 41%”做减法:一个可能讲性能,一个讲等性能功耗,起点与测试都不相同。
天玑的观察重点,是多核组织、缓存与内存系统的协同。联发科对 9600 Pro 宣传单核提升 17%、多核提升 15%;另一个“多核功耗下降 61%”则限定在上一代峰值性能水平。不能把它写成“性能同时提升 15%,功耗同时降低 61%”,除非官方明确给出同一测试点。
苹果的观察重点,是芯片和产品设计一起变化。A20 Pro 的官方介绍同时讨论芯片、内存封装与散热,因此持续性能提升同样不能全部归因到 CPU 核心。苹果强项如何落地,仍应落到同一任务的完成时间、能耗与温度上。
麒麟的观察重点,是改善的范围与稳定性。现有测试已经能支持 9050 Pro 在特定多核负载下有明显进步;要进一步判定它与上述全新平台的绝对位置,仍需要同版本、同方法、可复核的完整测试。本文没有取得满足这些条件的四方数据,因此不把官方百分比加工成虚构排名。
这并不妨碍比较技术路线:苹果和高通都强调定制 CPU 与平台整合,联发科强调其 CPU 组合与系统资源,华为当前把电路层连接优化摆到了更显眼的位置。但所有路线最终都必须接受相同问题的检验:用户付出多少功耗、温度和成本,得到了多少有效工作。
七、GPU、NPU 与散热:CPU 之外还有半张试卷
GPU 不能只数“核心”。不同架构的所谓核心,可能对应不同规模的执行资源;频率、缓存、带宽、驱动与图形 API 也都会影响结果。跨厂商比较 GPU 核心数,往往像只数发动机气缸而不看排量和整车。
NPU 的 TOPS 也需要前提。运算精度、稀疏性、算子覆盖、内存容量和模型大小不同,同样的 TOPS 未必对应相同速度。真正贴近使用的指标,是特定模型在相同精度与输出质量下的延迟、吞吐、功耗,以及能否持续运行。
相机同理。ISP 很重要,但成片还由传感器、镜头、曝光策略与后处理共同决定。不能因为某颗 SoC 的 CPU 排名靠后,就推出其手机拍照一定差;也不能把好照片反推成 CPU 性能更强。
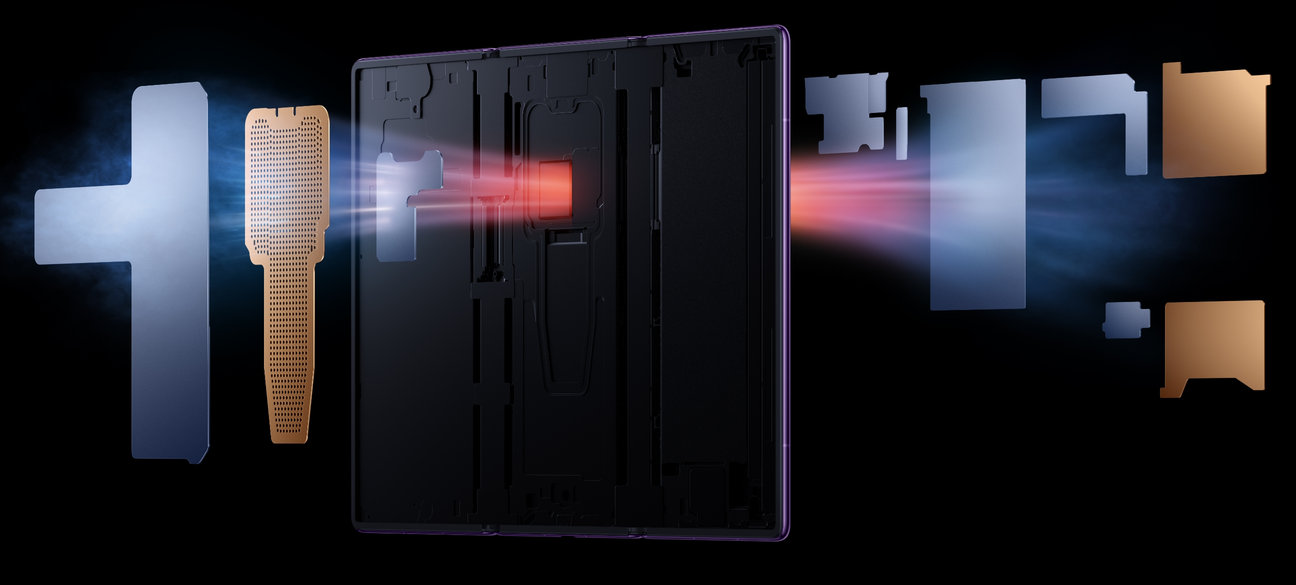
图 5:Mate XT 2 官方散热结构示意,用于说明芯片之外的整机条件。图源:华为产品页。它是结构宣传图,不是温度实测图。
手机最后要把热量传到机身,再传给环境。三折叠、直板旗舰和小尺寸手机,表面积、内部空间与热路径并不相同。即使搭载同一颗 SoC,厂商对表面温度的限制不同,也可能得出明显不同的持续性能。
这也是为什么严肃测试要记录环境温度、机型、系统、应用版本、性能模式和运行时长。一次冷机跑分回答的是“这一刻能冲多高”;半小时游戏回答的是“热平衡后能保持多少”。它们都有效,但回答不同问题。
八、回到购买和使用:该怎样评价今天的麒麟
如果主要需求是通信、社交、拍照和常见应用,应该优先看自己实际使用的软件是否完善,后台与通知是否可靠,续航和发热是否可接受。旗舰 CPU 峰值差距,并不一定按同样比例体现在这些日常任务中。
如果主要需求是高画质游戏、模拟器、长时间视频处理,峰值与持续性能就更重要。应优先寻找目标机型、目标软件的长测,而不是拿另一款手机的芯片标签作保证。原生适配与编译差异,也可能让同一款应用在不同系统上表现不同。
如果关注的是产业与技术进展,那么麒麟值得研究的地方,在于它如何在特定制造条件下,通过电路、封装、架构和软件的共同调整继续提高产品能力。LogicFolding 的公开论文与零售机能效测试,使这条路线可以被具体讨论,而不必停留在口号层面。
对这代产品,一个审慎的判断是:进步值得承认,边界同样需要保留。9050 Pro 的部分多核能效结果已经相当有说服力;它是否在所有维度达到或超过当年最强平台,需要更多同条件证据。韬定律提供了一种值得跟踪的工程思路,但它没有免除工艺、热、成本和软件的约束。
真正有意思的,不是哪一家发布会上的数字最大,而是下一次把手机接上电源仪、跑完同一套任务之后,曲线会往哪里移动。
资料说明与复核入口
本文把资料分成三层:海思及四家厂商页面用于确认公开规格;论文与拆解用于解释设计和制造;极客湾原视频及 SOCPK 用于观察独立测试。正文所有性能判断均受对应测试条件限制。
- 历史规格:海思麒麟 970、980、9000。
- 当前麒麟:Mate XT 2 官方资料、LogicFolding 商业应用说明。
- 时间缩放:正式论文与许可、热设计后续预印本。两篇材料的发表状态不同,不能混称。
- 独立数据:极客湾 9050 Pro 原始视频、SOCPK、SMIC N+3 拆解。
- 测试尺度:Geekbench 7 官方说明。
配图以官方会议照片和官方发布素材为主,辅以一张注明出处的测评曲线。除已明确列出的知识共享材料外,图片权利归原作者或厂商;本文为相关产品与技术评论引用。文中分析与表格整理不代表任何厂商或测评机构立场。