资料核验于北京时间 2026 年 10 月 1 日。Google 发布页日期为 9 月 30 日;正式名称是 Gemini 4 Argon,不是此前流传的“Gemini 4 Pro”。本文是公开资料分析,没有进行本站 API 实测。配图均为 Artificial Analysis 发布的原始跑分图,保留署名与坐标,没有使用 AI 生成图片;点击图片可查看大图。
这次 Gemini 4 最值得关注的,是 Google 终于拿出了能与当前前沿模型竞争的新一代大模型。但如果把消息压缩成“Pro 已经全面开放”“跑分第一,所以所有任务最强”或“比 Astra 永久便宜四成”,就会漏掉影响实际使用的条件。
我的判断是:Argon 的企业工作流能力值得认真评估,促销期的价格也有吸引力;但它的优势有明显的任务边界,今天更适合进入候选名单,而不是仅凭发布日跑分直接替换现有工作流。
先说清楚:发布了什么,谁能使用
Google 正式发布文章将 Argon 定位于复杂软件工程、企业知识工作与网络安全防御。初始访问提供给 Fairwind Program 中一部分受信任的网络安全防御伙伴,面向开发者、企业和消费者的更广泛开放仍待后续推进。
因此,“公布模型”和“所有 Gemini 用户现在就能切换到它”是两件事。也不能由模型能力发布,推断现有 Google AI Pro 订阅马上获得相同入口、额度和工具权限。
这一区别决定了文章应该怎样写:现在可以讨论公开证据和接入前的评估思路,却不适合编造“我已连续使用一周”的体验,更不能把传闻中的型号、价格和成绩拼到正式产品上。
综合跑分:回到前沿,但没有全面登顶
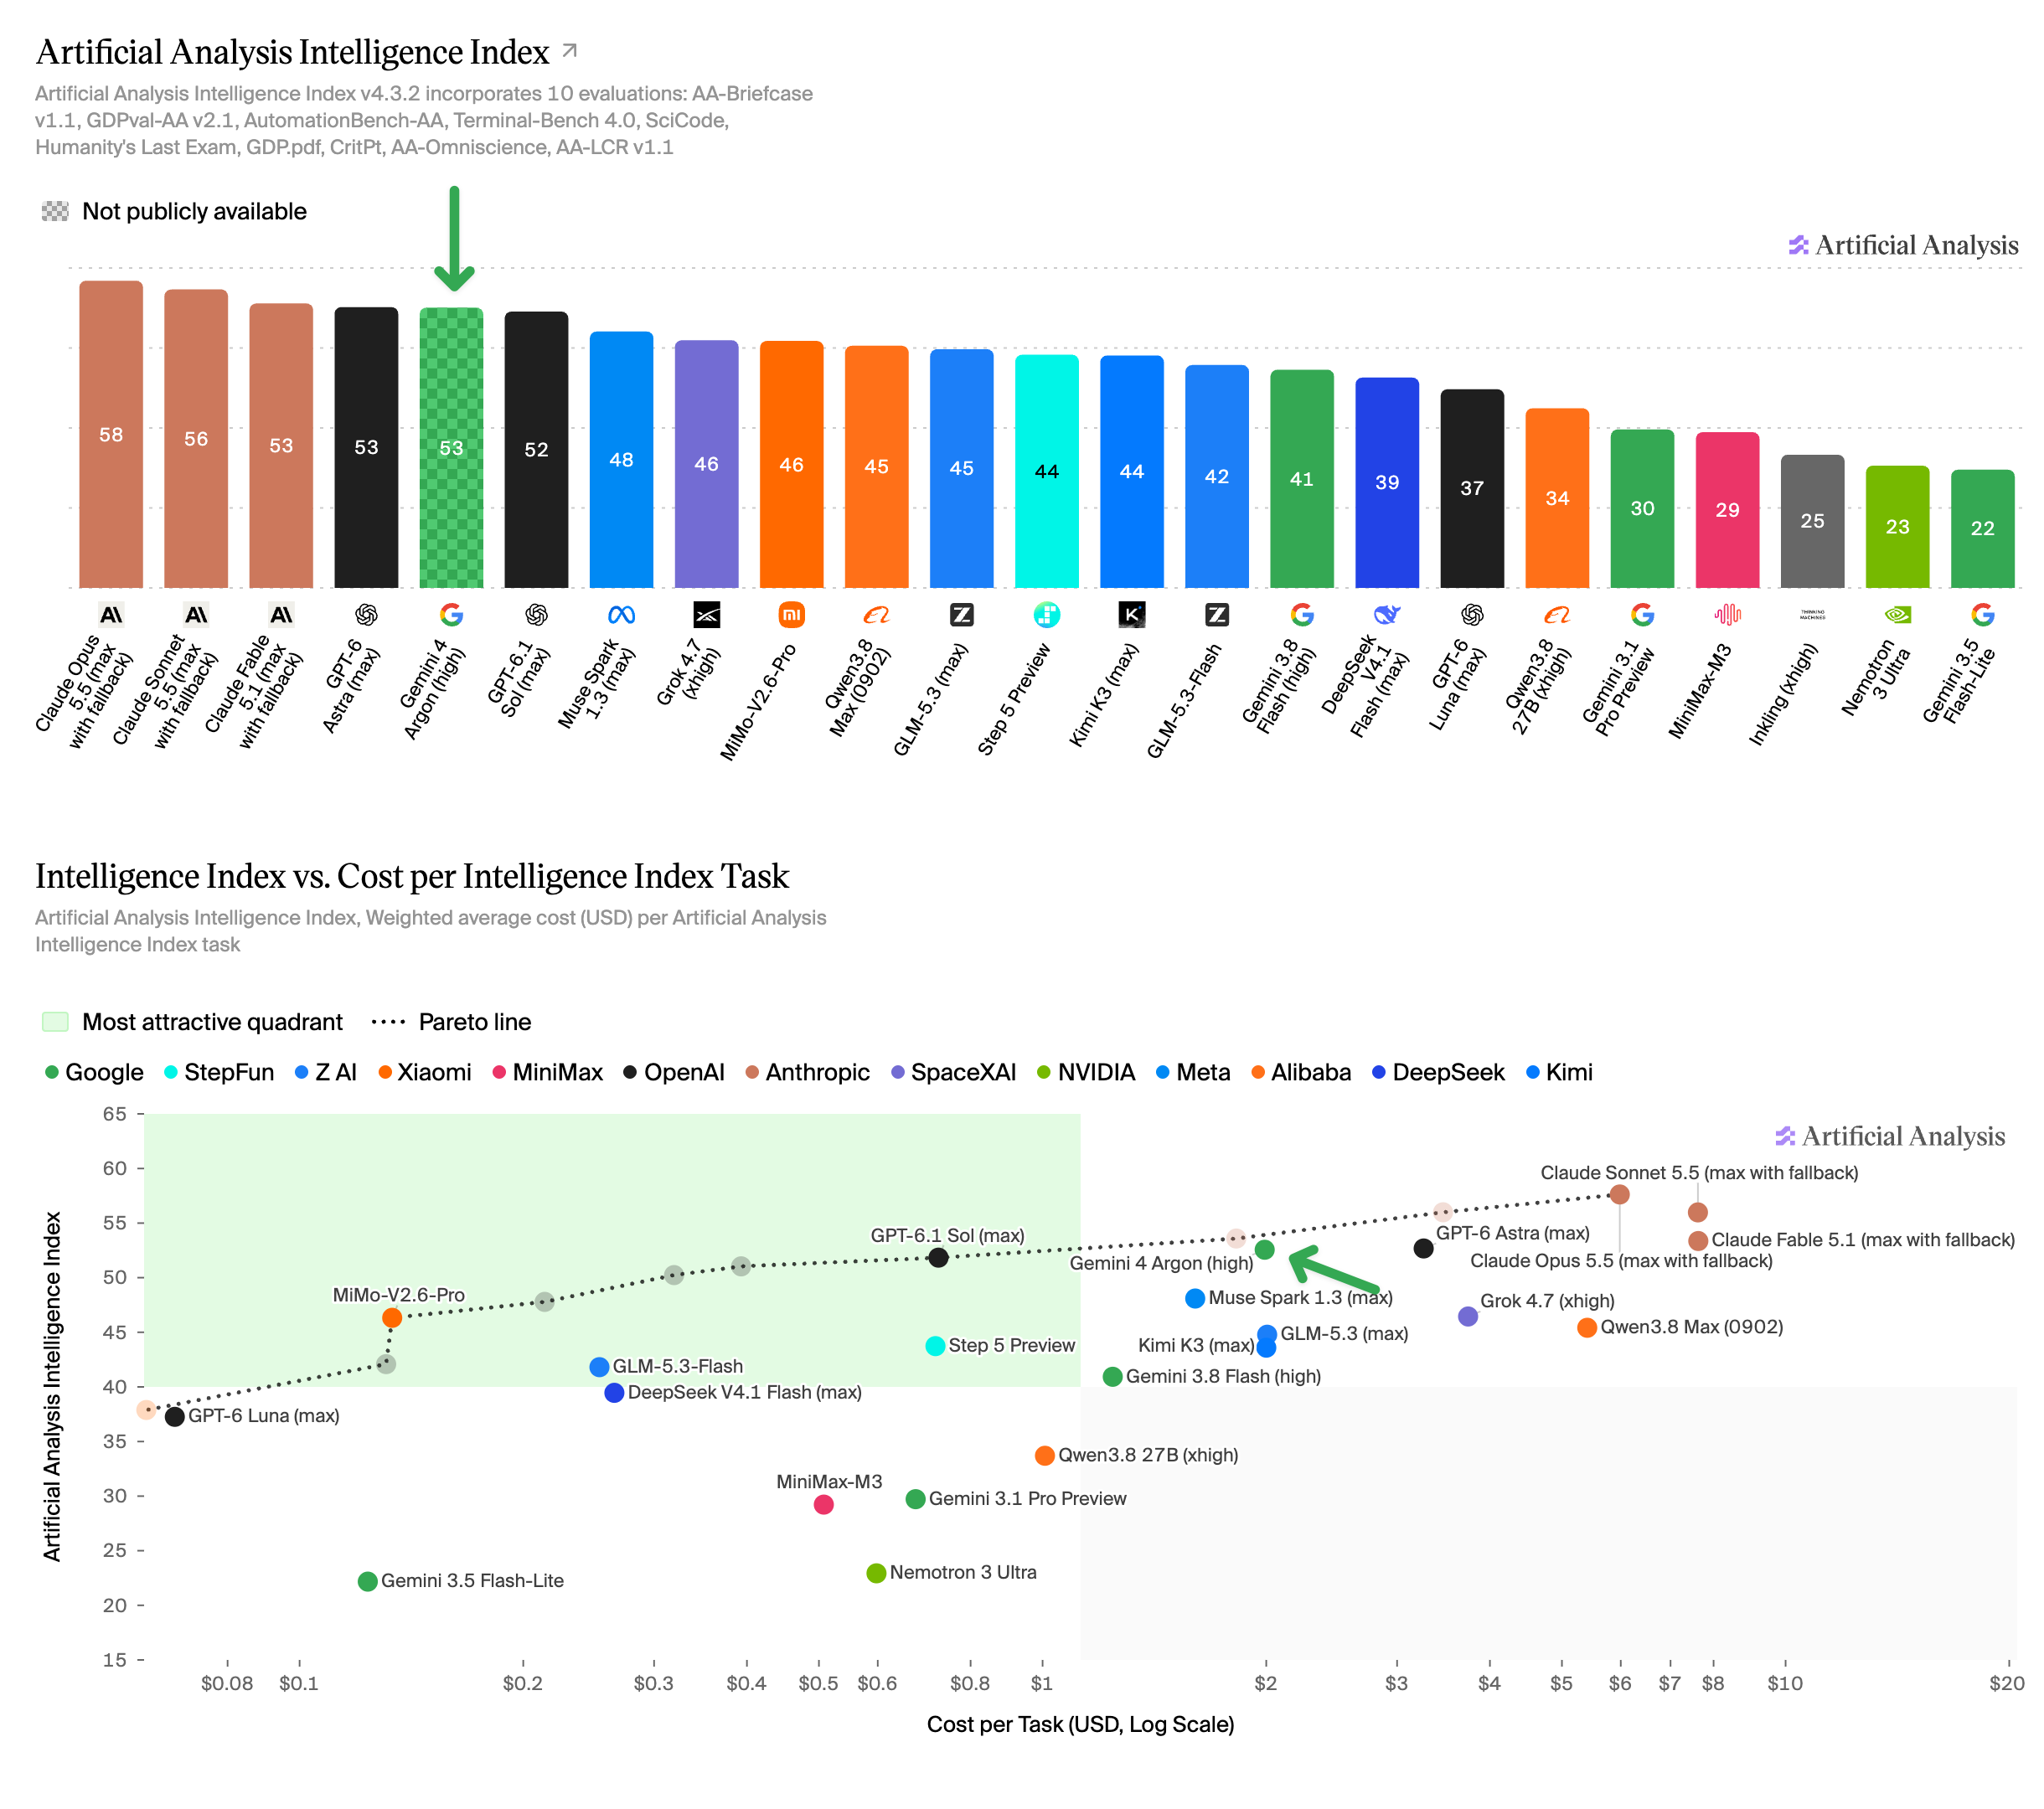
图 1:Artificial Analysis 发布原图。上半部分为 Intelligence Index v4.3.2,下半部分为智能指数与每任务成本;成本横轴为对数刻度。来源:AA 发布分析。图中的棋盘纹理标记“尚未公开可用”,不是误差条。
AA 模型页记录,Argon 在 high 推理档的智能指数为 53。同一张发布图里,GPT-6 Astra(max)也是 53,GPT-6.1 Sol(max)为 52,Claude Opus 5.5 和 Sonnet 5.5 则分别为 58 和 56;图中的 Anthropic 档位同时标注了 fallback 条件。
这说明 Google 已重返前沿竞争,却不支持“所有方面碾压”的结论。综合指数也不是答题正确率:53 分不等于任意实际任务有 53% 的成功率。模型档位、测评集合、权重和工具环境共同构成了这个数字。
另一家测评机构 Vals AI 的 Vals Index v2.1给出的榜单不同:Argon 以 68.90% 位列第一,Sonnet 5.5 为 67.04%,Opus 5.5 为 66.97%。该指数聚合金融、编程、法律和税务任务,并按相关行业在美国 GDP 中的比重加权。
两个榜单的差异并不意味着其中一个“测错了”。它们回答的问题不同。对于企业采购,任务权重更贴近自身业务的评测可能更有用;对于个人使用,GDP 权重并不天然代表写作、聊天、中文审美或日常代码修改的重要程度。
更合理的读法,是先找出哪类任务推动了得分,再看这些任务在自己的工作中出现得多不多。总分相同的模型,可以拥有完全不同的优势组合。
工作流与编程:强项确实存在,也有明确短板
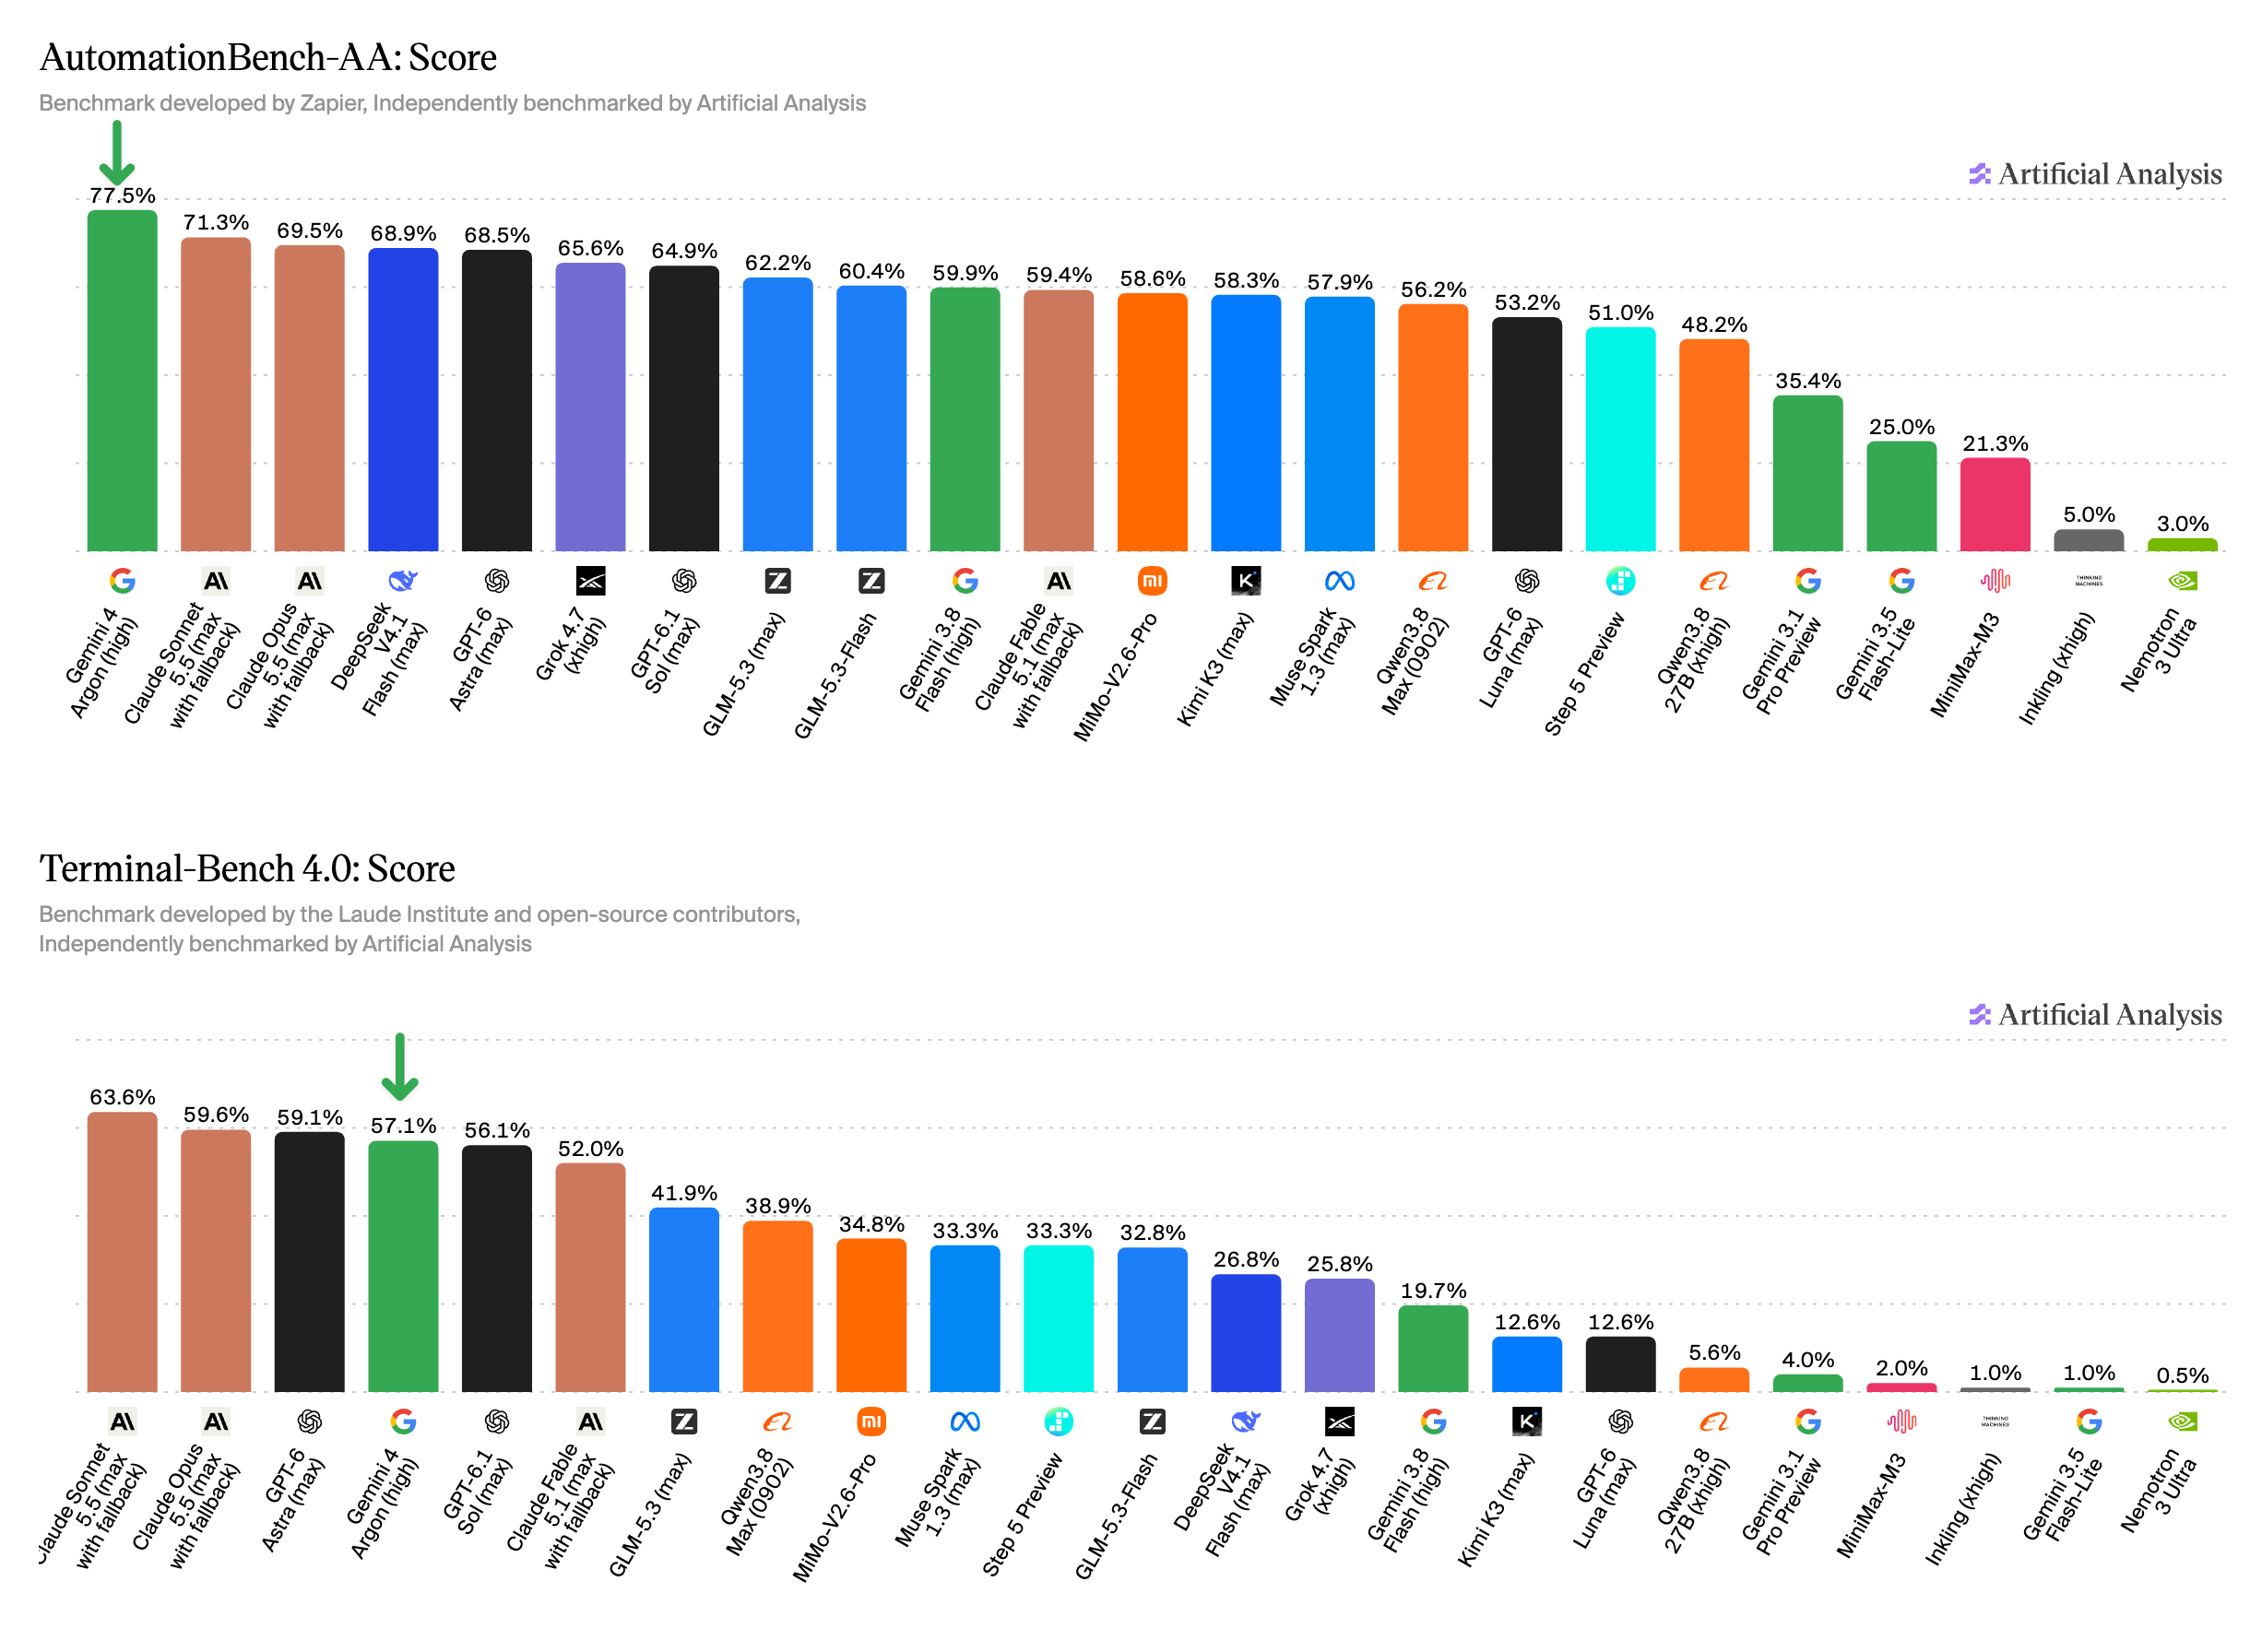
图 2:AA 独立测试的业务自动化与终端任务原图。来源:AA 发布分析。同一模型在两个任务集合中的名次不同,正是不能只看总分的例子。
AutomationBench-AA 页面显示,Argon 得分 77.5%,领先 Sonnet 5.5 的 71.3% 和 Opus 5.5 的 69.5%。但图中的 Terminal-Bench 4.0 成绩为 57.1%,落后于 Sonnet 5.5 的 63.6%、Opus 5.5 的 59.6% 和 Astra 的 59.1%。
对一个需要跨业务软件完成流程的代理,前一个结果很有吸引力;对需要持续调试、操作终端和验证代码的助手,后一个结果提醒我们:业务自动化优势不能直接换算成编程全能。
Google 官方性能表也呈现出这种不均衡:Argon 的 DeepSWE v1.1 为 77.9%,高于表中 Astra 的 74.1%;但 FrontierSWE v2 为 55.0%,低于 Astra 的 65.5%。这些是 Google 汇总的官方表格成绩,不是本站同条件复测,也不能与 AA 的终端测试混成一张“统一实力榜”。
尤其需要读官方评测方法:部分项目由 Google 自测,竞品成绩可能取自厂商报告或公开榜单;Terminal-Bench Science 对 Argon 的验证器超时时间作了六倍放宽;OSWorld 报告的是离线子集的部分得分,并在三轮单次尝试运行中取最高值。
这些备注不会自动推翻成绩,但会限制结论。部分步骤得分不等于完整任务完成率,增加验证时间也不等于模型在相同时间预算下更强。公平比较需要同时看模型、工具、时间预算和判分方式。
“低幻觉”很有价值,但不等于知道更多
AA 发布分析报告,Argon 在 AA-Omniscience 上的幻觉率为 15%,而准确率为 50%;Astra 的准确率为 63%。这组数应一起读,不能只截取“15%”当作所有回答场景的出错概率。
这更像两种策略的取舍:不知道时愿意承认不确定,通常比给出一个自信但错误的答案更容易纳入可控流程;但拒答或保留意见,仍然可能让任务无法完成。知识覆盖、回答意愿与答案可靠性,需要分别衡量。
对引用整理、资料检索和企业文档处理,我会把“能否明确说不知道”视为实际优点,再要求可核查来源和缺失信息清单。对必须给出完整方案的任务,还要记录它需要多少次补充材料或人工接手。低幻觉可以减少误导,却不会自动替代证据核验。
价格:促销期的好看数字,需要放进长期预算
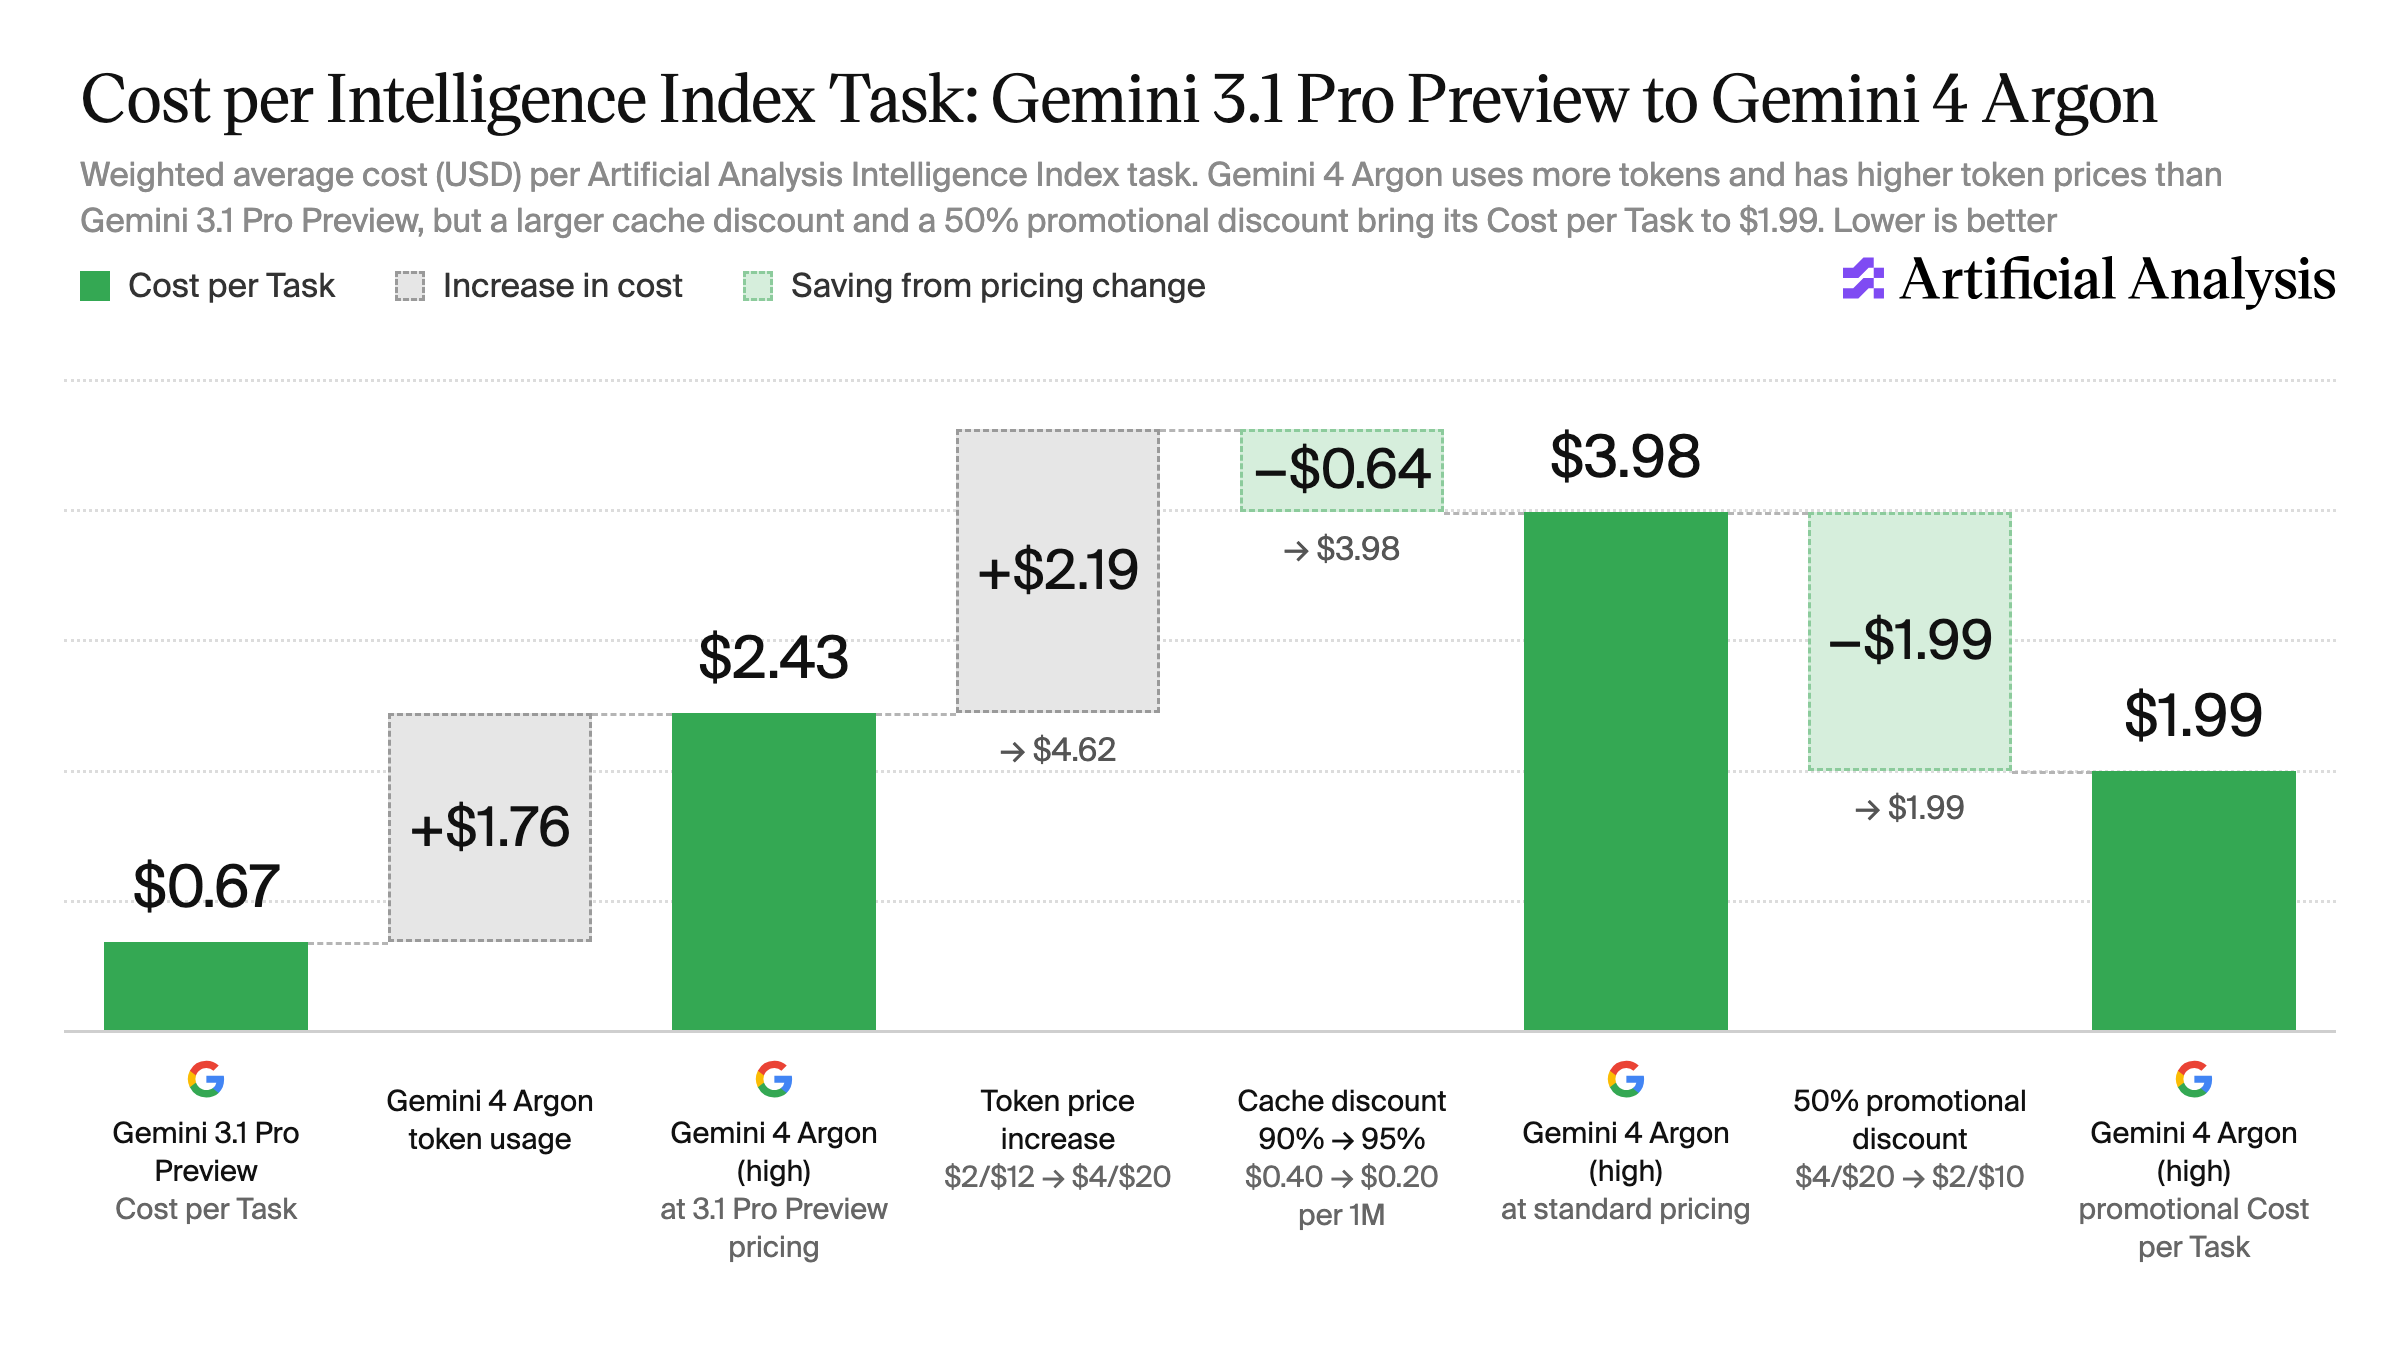
图 3:AA 的成本分解原图,展示 token 用量、标准价格、缓存折扣和 50% 促销分别怎样影响每任务成本。来源:AA 发布分析。这是该测试集合的成本,不是所有业务任务的固定报价。
Google 公布的介绍期价格为每百万输入/输出 token 2/10 美元,缓存输入按输入单价打 95% 折扣;介绍期结束后对应为 4/20 美元。截至本文核验,不能把介绍期价格写成永久定价。Google 定价说明
AA 图中 Argon 的促销期每任务成本为 1.99 美元,按标准价格则为 3.98 美元;其发布分析给出 Astra 为 3.26 美元。因此,“比 Astra 便宜约四成”描述的是特定评测集合、当前折扣与缓存条件下的结果;撤掉折扣,同一成本比较就会改变方向。AA 成本分析
这里真正值得关注的是成本结构。便宜的 token 不保证便宜的完成任务,更多推理、重试和工具等待都可能吃掉单价优势。缓存也依赖业务是否经常重复相同上下文,不能默认每次请求都享受最大节省。
我会分别做促销期与标准价预算,并把人工复核和失败重跑计入总成本。用于一次性研究,短期折扣可能很有吸引力;用于常年运行的生产服务,则应首先确认折扣结束后的账单仍能接受。
大输出窗口:给困难任务更多空间,也给成本更多空间
Google 还强调将输出上限扩展到 100 万 token;这说的是输出能力,不是让用户一次输入百万字的承诺。AA 说明其测试采用了 Long Decode Continuation:长响应暂停后通过后续调用继续生成,避免单次请求超时。Google 发布页 · AA 技术说明
这种机制为复杂问题提供了更长的推理轨迹,但输出更长不一定结果更好。工程上仍需要超时、费用上限、断点恢复与阶段验收。否则一条长时间生成的轨迹可能直到最后才暴露方向错误,返工会比短任务更昂贵。
真正该测试的,是增加预算后成功率怎样变化:多给十分钟或更多输出额度,是否解决了原本解决不了的问题?如果只是解释变长,就不能把额外支出算作能力收益。
我的结论:值得进入候选,暂不适合盲目换默认
对复杂企业流程、金融与法律材料处理,Argon 值得优先安排业务样本测试。对终端编程和仓库维护,仍应保留其他前沿模型作对照。对日常低成本任务,强模型是否必要,需要由任务难度和失败代价决定。
接入后,我会固定一组真实任务,记录首次验收通过率、返工次数、引用可核查率、总耗时与每次成功交付成本。同时保留失败案例,并把促销价与标准价分别计算。这样才能判断它在自己的工作中是否有价值,而不是只重复发布图里的排名。
Gemini 4 Argon 的发布带来了更有竞争力的选择,也让前沿模型的比较更需要细分。它的价值应由可复核的任务结果决定;名称、总分和短期折扣,都只是评估的起点。
来源与配图说明
- Google:Gemini 4 Argon 正式发布
- Google DeepMind:官方性能表
- Google DeepMind:评测方法 PDF
- Artificial Analysis:发布分析及本文三张跑分原图
- Artificial Analysis:Argon 模型页
- Artificial Analysis:AutomationBench-AA
- Vals AI:Vals Index v2.1 榜单与方法
本文经 AI 辅助检索与写作,为发布日公开证据分析,不是独立亲测。图片版权归 Artificial Analysis;本文引用原图用于逐项评论,未重绘、未修改成绩、未去除署名。榜单会更新,文中数据及图片以本次核验的发布快照为准。